在社会科学研究中,研究者常常需要判断某项政策、事件或制度变迁是否真正产生了影响,例如环保政策是否改善空气质量、自由贸易区是否促进经济增长、招生改革是否改变学生发展结果等。这类问题的核心在于如何识别因果效应,即如何估计研究对象在“没有受到干预”时本应出现的结果,也就是所谓的“反事实”。然而,在现实中,同一个地区或组织一旦接受政策干预,就无法同时观察其未受干预的状态。传统研究通常借助双重差分法、工具变量法、匹配法等方法构造对照关系,但在许多政策评估场景中,处理组往往只有一个或少数几个对象,单独寻找一个完全相似的对照对象并不容易。合成控制法正是在这一背景下产生的,它通过将多个未受政策影响的对象按一定权重组合起来,构造出一个在政策实施前与处理组高度相似的“合成对照组”,并将其作为政策实施后的反事实参照。通俗地说,合成控制法就是用多个地区“拼出”一个最像处理地区的虚拟对象,再通过比较真实处理组与合成控制组之间的差异,评估政策或事件可能带来的影响。
一、合成控制法的基本原理
(一)核心思想
合成控制法,英文为 Synthetic Control Method,简称 SCM。它主要适用于以下研究情境:某一地区、组织或群体在某个时间点之后受到政策、制度或事件冲击,而其他类似对象没有受到同样冲击。研究者希望评估这一冲击对结果变量产生了多大影响。
设想某省在2015年开始实施一项产业扶持政策,研究者想评估该政策对该省GDP增长率的影响。直接比较政策实施前后GDP的变化并不充分,因为经济增长受到宏观经济周期、产业趋势、人口流动等多种因素影响。直接拿另一个省作对照也可能存在问题,因为两个省的初始条件和发展路径可能不同。
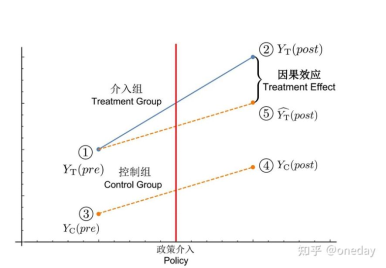
合成控制法的做法是,从没有实施该政策的其他省份中选取若干个省作为“供体池”,再通过加权组合构造一个“合成省份”。如果这个合成省份在2015年以前的GDP增长率、产业结构、人口规模、财政支出等指标上都与真实处理省份高度相似,那么我们就可以认为,政策实施后合成省份的变化趋势可以近似代表处理省份在没有实施政策时的反事实趋势。两者之间的差距,就可以被解释为政策的估计效果。
(二)模型表达
从形式上看,假设共有J+1个研究对象,其中第1个对象是处理组,其余J个对象是未受干预的控制组。政策在某一时间点T0之后实施。合成控制法的目标,是为这些控制组对象寻找一组权重:
W=(w2,w3,……,wJ+1)
其中,每个权重大于或等于0,且所有权重之和等于1。权重越大,说明该控制对象在构造合成对照组时越重要。研究者通过算法寻找一组最优权重,使得政策实施前,合成对照组在结果变量和预测变量上的表现尽可能接近处理组。
政策实施后的因果效应可以表示为:
政策效应=真实处理组结果-合成控制组结果
如果政策实施前二者走势高度一致,而政策实施后二者出现明显差距,那么这种差距就可以为政策效果提供经验依据。当然,能否将差距解释为因果效应,还取决于研究设计是否满足相关假设。
(三)一个直观例子
假设我们要研究某城市推行垃圾分类政策后,生活垃圾清运量是否下降。该城市是处理组,其他未推行类似政策的城市构成供体池。研究者可以利用政策实施前若干年的垃圾清运量、人均收入、人口密度、产业结构、居民受教育水平等指标,寻找一组城市权重。比如:
合成城市=0.35×城市A+0.25×城市B+0.20×城市C+0.20×城市D
如果这个“合成城市”在政策实施前与真实城市的垃圾清运量变化趋势几乎一致,那么在政策实施后,合成城市的垃圾清运量就可以作为真实城市“如果没有推行垃圾分类政策”的参照。若真实城市的垃圾清运量明显低于合成城市,便说明该政策可能产生了减少垃圾清运量的效果。
二、合成控制法的操作步骤
(一)确定研究对象和干预时间
使用合成控制法的第一步,是明确“谁受到了干预”以及“干预从什么时候开始”。处理组可以是一个国家、一个省份、一个城市、一所学校、一个企业或一个平台。干预可以是政策出台、制度改革、重大事件发生、项目启动等。
需要注意的是,干预时间应当相对清晰。如果政策实施是长期渐进的,或者不同地区在不同时间陆续受到干预,传统合成控制法的应用就会更加复杂,可能需要使用广义合成控制法、交错处理设计或其他扩展方法。
(二)选择合适的供体池
供体池是指用于构造合成控制组的候选对象。一个好的供体池需要满足两个条件:第一,这些对象没有受到同一政策或事件的直接影响;第二,它们与处理组具有一定可比性。
例如,研究某一省份自贸区政策时,供体池可以选择未设立自贸区且经济结构相近的省份;研究某城市交通限行政策时,供体池可以选择没有实行类似限行政策的其他城市。如果供体池中包含受政策间接影响的对象,可能会产生“溢出效应”问题,导致估计结果偏误。
(三)选择预测变量和结果变量
结果变量是研究者真正关心的结果,如经济增长率、就业率、污染排放量、居民收入、创新产出等。预测变量则是影响结果变量的重要前置因素。合成控制法通常要求预测变量在政策实施前已经被观察到,且不应受到政策本身影响。
预测变量的选择不能只依赖统计显著性,更应结合理论机制。例如,研究环保政策对空气质量的影响时,可以考虑工业结构、能源消费、人口密度、机动车保有量、气象条件等变量;研究教育政策对升学结果的影响时,可以考虑学校规模、师资水平、生源结构、历史升学率等变量。
(四)检验政策实施前的拟合效果
合成控制法最重要的诊断步骤之一,是观察政策实施前处理组与合成控制组是否足够接近。如果政策实施前二者差异很大,那么政策实施后的差异就很难被解释为政策效果。换句话说,一个可信的合成控制组,必须先在“过去”像处理组,才有资格在“未来”代表处理组的反事实状态。
因此,研究者通常会绘制政策实施前后的趋势图,并报告均方预测误差等指标。如果政策前拟合效果较差,研究者需要重新检查供体池、预测变量、时间范围和模型设定,而不能直接解释政策效应。
(五)进行安慰剂检验和稳健性检验
为了增强结果可信度,合成控制法通常需要进行安慰剂检验。常见做法是:把供体池中的其他对象也假设为“处理组”,分别构造它们的合成控制组,并计算“虚假政策效应”。如果真实处理组的政策效应明显大于大多数安慰剂结果,则说明该效应不太可能只是偶然波动。
此外,研究者还可以进行剔除检验。例如,依次删除权重较高的供体对象,观察结果是否发生明显变化。如果删除某一个对象后结论完全改变,就说明研究结果可能过度依赖个别控制对象,需要谨慎解释。
三、合成控制法的优势与局限
(一)主要优势
第一,合成控制法具有较强的直观性。它不是简单地选择一个控制组,而是明确告诉读者:合成对照组由哪些对象组成,每个对象的权重是多少。这种透明性使研究过程更容易被理解和复核。
第二,合成控制法适合少数处理对象的政策评估。对于国家、省份、城市、学校等宏观单位,随机实验往往难以实现,而处理对象也通常较少。合成控制法能够较好地处理这类比较案例研究。
第三,合成控制法强调政策前趋势匹配。相比只比较平均差异的方法,合成控制法更加重视干预发生前的历史轨迹。如果政策前处理组与合成控制组走势高度一致,政策后的偏离就更具有解释力。
第四,合成控制法的结果展示较为清晰。通过趋势图,读者可以直观看到政策前后的变化,这也使其非常适合用于政策评估报告和公众号方法介绍。
(二)主要局限
第一,合成控制法对数据质量要求较高。研究者需要较长的政策前时间序列数据,也需要多个可比的控制对象。如果数据时间太短,或者供体池对象太少,就很难构造出可靠的合成控制组。
第二,合成控制法主要识别的是局部、个案性质的政策效应。它评估的是某一具体对象受到某一政策影响后的变化,结论未必能直接推广到所有地区或所有情境。
第三,供体池选择会影响结果。如果供体池中包含不合适的对象,或者遗漏了重要的可比对象,合成控制结果可能发生变化。因此,供体池的构建需要有充分理论依据。
第四,合成控制法难以处理明显的政策溢出。如果未处理地区也受到处理地区政策的间接影响,那么这些地区就不再是干净的对照对象。例如,一个城市实施产业政策后,周边城市也可能受到产业转移、人口流动或投资变化的影响,这会影响合成控制组的有效性。
四、合成控制法的应用场景
(一)政策评估研究
合成控制法最常见的应用是政策评估。例如,评估自贸区设立对城市经济增长的影响、低碳城市试点对碳排放的影响、限购政策对房地产价格的影响、医疗改革对居民健康支出的影响等。只要政策具有明确实施时间,且存在未受影响的可比地区,就可以考虑使用合成控制法。
(二)区域经济与城市研究
在区域经济研究中,处理对象往往是某个国家、省份或城市。这类对象数量有限,很难通过传统随机实验识别因果效应。合成控制法可以根据多个地区的历史数据构造反事实路径,因此特别适合研究区域发展战略、产业政策、基础设施建设和重大活动影响。
(三)公共管理与社会政策研究
公共管理领域也经常使用合成控制法。例如,研究某项教育改革是否提高学生成绩,某项社会救助政策是否降低贫困率,某项公共卫生政策是否减少疾病传播,某项治安治理措施是否降低犯罪率。由于很多公共政策具有地区试点特征,合成控制法能够为这类试点政策提供较为清晰的评估思路。
(四)重大事件影响评估
除了政策干预,合成控制法也可以用于评估重大事件的影响。例如,恐怖袭击、自然灾害、国际制裁、重大赛事、突发公共卫生事件等,都可能对某一地区或国家产生冲击。研究者可以利用未受事件影响的对象构造合成对照组,估计事件发生后的影响程度。
五、使用合成控制法时的注意事项
(一)不要只看政策后的差异
很多初学者容易把政策实施后处理组与控制组之间的差异直接解释为政策效果。事实上,政策后的差异是否有意义,取决于政策前拟合是否足够好。如果政策前二者本来就差异很大,政策后的差异就可能只是原有趋势的延续。
(二)不能忽视理论机制
合成控制法虽然依赖数据和算法,但它并不是“把数据丢进模型就能得到因果结论”的工具。研究者仍然需要解释政策为什么会影响结果变量、影响通过什么机制发生、哪些变量应当被纳入预测变量、哪些对象适合作为供体池。缺乏理论支撑的合成控制分析,很容易变成形式化的统计比较。
(三)重视稳健性检验
一篇规范的合成控制法论文,通常不会只报告一张趋势图,而会进一步展示安慰剂检验、剔除检验、替换供体池检验、改变预测变量检验等结果。这些检验有助于说明研究结论并非由偶然因素或个别对象驱动。
(四)谨慎解释外推结论
合成控制法的优势在于对具体案例进行深入评估,但这也意味着它的外推能力有限。例如,某一城市的环保政策产生了明显效果,并不必然说明其他城市实施同样政策也会产生相同效果。不同地区的产业结构、财政能力、治理水平和社会环境都可能影响政策效果。
六、结语:从“寻找对照组”到“构造反事实”
合成控制法为政策评估提供了一种非常有启发性的思路。它不再要求研究者找到一个天然完全相似的对照对象,而是通过多个未处理对象的加权组合,构造出一个尽可能接近处理组历史轨迹的“合成对照组”。这种方法既保留了比较研究的直观性,又提高了反事实构造的严谨性。
对于公共政策、区域经济和社会治理研究而言,合成控制法尤其适合用于评估那些发生在少数地区、具有明确时间节点、且无法随机分配的政策或事件。当然,任何方法都有适用边界。使用合成控制法时,研究者必须认真选择供体池,检验政策前拟合效果,并通过多种稳健性检验提高结论可信度。
简而言之,合成控制法的核心不只是“合成”一个对照组,而是用数据和理论共同回答一个因果推断问题:如果没有这项政策,处理对象本来会怎样?
文献引用:
[1] Abadie, A., Diamond, A., & Hainmueller, J. (2010). Synthetic Control Methods for Comparative Case Studies: Estimating the Effect of California’s Tobacco Control Program. Journal of the American Statistical Association, 105(490), 493–505.
[2] Abadie, A. (2021). Using Synthetic Controls: Feasibility, Data Requirements, and Methodological Aspects. Journal of Economic Literature, 59(2), 391–425.